Software
AIMY 2의 소프트웨어 구성을 설명합니다.
개요
AIMY 2는 ROS 2(Robot Operating System 2)를 기반으로 하는 대화형 안내 로봇 시스템입니다. 음성 인식부터 대화 생성, 음성 응답, 제스처, 표정까지 하나의 파이프라인으로 통합되어 동작합니다.
소프트웨어 스택
- 운영체제: Ubuntu 22.04 LTS
- ROS 버전: ROS 2 Humble
- 음성 인식(STT): Whisper large-v3 (로봇 내장 GPU에서 로컬 실행)
- 대화 생성(LLM): 생성형 AI 연동 (클라우드 API)
- 음성 합성(TTS): 클라우드 TTS API
- 제스처 생성: 딥러닝 기반 음성-제스처 동기화 모델 (로컬 실행)
- 얼굴 감지: YOLOv7-tiny (전용 엣지 컴퓨터에서 실행)
시스템 구성
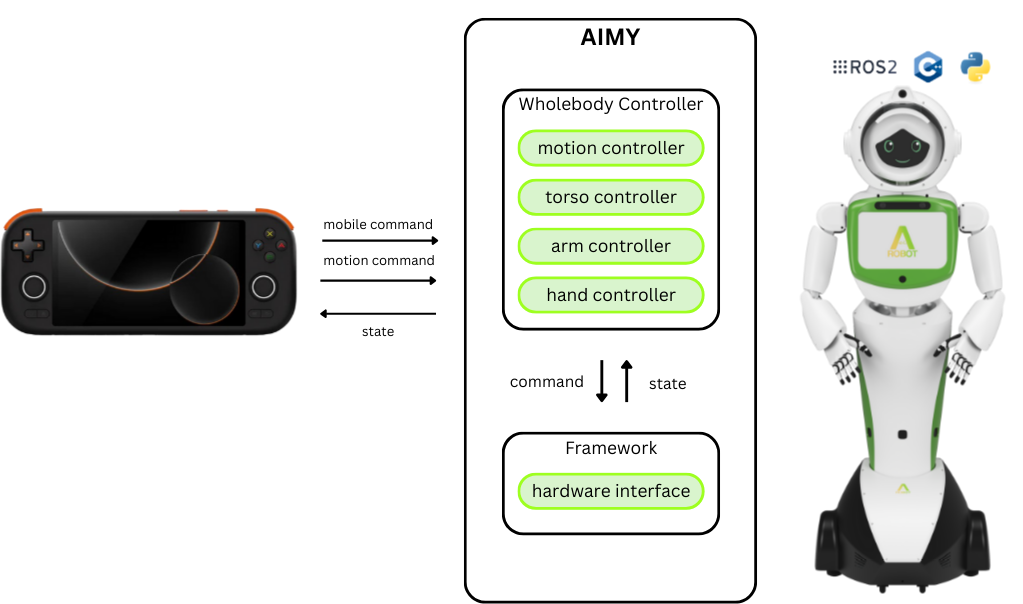
AIMY 2의 소프트웨어는 다음과 같이 구성됩니다.
대화 파이프라인
방문객 발화
  → 음성 인식 (STT, 로봇 내장 GPU 로컬 실행)
  → 대화 응답 생성 (LLM, 클라우드 API)
  → 음성 합성 (TTS, 클라우드 API) + 제스처 생성 (로컬 실행)
  → 음성 응답 재생 + 제스처 연출 + 표정 변화
- 음성 인식과 제스처 생성은 로봇 내부에서 수행되므로 네트워크 상태와 무관하게 동작합니다.
- LLM/TTS는 클라우드 API를 사용하며, 네트워크 불안정 시에도 로봇이 중단되지 않도록 예외 처리가 적용되어 있습니다.
음성 인식 (STT)
- Whisper large-v3 모델을 로봇 내장 GPU에서 로컬 실행합니다. (클라우드 의존 없음)
- silero VAD로 사람 목소리 구간을 실시간 감지하여, 말이 끝나면 바로 인식을 시작합니다.
- 에코 캔슬링(AEC) 적용으로 로봇이 답변을 말하는 동안에도 방문객의 다음 발화를 동시에 들을 수 있습니다.
대화 생성 (LLM)
- 생성형 AI(LLM)가 방문객 질문에 대한 답변을 생성합니다.
- 로봇의 페르소나(도서관 안내원)와 답변 성향은 시스템 프롬프트로 설정됩니다.
음성 합성 (TTS)
- 클라우드 TTS API로 자연스러운 한국어 음성을 생성합니다.
- 음성의 종류, 속도, 톤 등은 설정으로 조정 가능합니다.
제스처 생성
- Seq2Seq 딥러닝 모델(양방향 GRU + 어텐션)이 발화 텍스트와 한국어 워드 임베딩을 입력받아 포즈 시퀀스를 생성합니다.
- 생성된 제스처는 답변 음성의 길이에 맞춰 시간 배분되어 음성과 동기화되어 재생됩니다.
- 제스처 종료 후에는 자동으로 기본 자세로 복귀합니다.
얼굴 감지 (비전)
- 전용 엣지 컴퓨터에서 YOLOv7-tiny 경량화 모델(TensorRT 가속)로 카메라 영상에서 얼굴을 실시간 감지합니다.
- 감지된 방문객을 추적하여 인사 타이밍 결정과 시선 추적에 사용합니다.
상호작용
- 사람 감지: 카메라로 방문객을 감지하면 인사 모션과 함께 대화를 시작합니다.
- 시선 추적: 대화 상대의 위치를 추적하여 고개 각도를 조절합니다.
- 표정 연출: 대화 상태에 따라 눈 깜빡임, 미소 등의 표정을 표시합니다.
- 안내 화면: 대화 진행 여부에 따라 도서관 안내 웹페이지의 화면을 전환합니다.
제어
- 상체 관절은 ros2_control 기반 제어기(200Hz)로 구동됩니다.
- 이동 베이스는 바퀴 구동 명령(속도 지정)으로 제어됩니다.
- 조이스틱 및 전용 조작 앱으로 수동 조종할 수 있습니다.
시스템 운영
- 전원을 켜면 로봇이 자동으로 모든 기능을 시작합니다.
- 배터리 전압을 상시 감시하여 저전압이 일정 시간 지속되면 자동으로 안전 종료합니다.
- 기능별로 독립 실행되므로, 일부 기능에 문제가 생겨도 나머지 기능은 계속 동작합니다.